ACUITY Toolkit 使用示例
这里将以 Keras 格式的 MobileNetV2 目标识别模型为例子,将使用 Acuity Toolkit 对模型进行解析,量化和编译,并生成项目代码,并使用 Vivante IDE 进行模拟仿真,最后在 VIP9000 系列 NPU 上进行推理。
NPU 版本对照表
| 产品 | 算力 | 平台 | NPU 版本 | NPU 软件版本 |
|---|---|---|---|---|
| Radxa A5E | 2 Tops | T527 | v2 | v1.13 |
| Radxa A7A | 3 Tops | A733 | v3 | v2.0 |
| Radxa A7Z | 3 Tops | A733 | v3 | v2.0 |
| Radxa A7S | 3 Tops | A733 | v3 | v2.0 |
下载例子仓库
在 ACUITY Docker 容器 中下载示例仓库
下载仓库
git clone https://github.com/ZIFENG278/ai-sdk.git
配置模型编译脚本
- A733
- T527
cd ai-sdk/models
source env.sh v3 # NPU_VERSION
cp ../scripts/* .
cd ai-sdk/models
source env.sh v2 # NPU_VERSION
cp ../scripts/* .
指定 NPU_VERSION, A733 指定 v3, T527 指定 v2。 信息对照请参考 NPU 版本对照表
模型解析
在 Docker 中进入示例仓库中的 ai-sdk/models/MobileNetV2_Imagenet 模型例子目录。
cd ai-sdk/models/MobileNetV2_Imagenet
此目录中包含以下文件,其中:
- MobilNetV2_Imagenet.h5 为原模型文件(必要)。
- channel_mean_value.txt 为模型输入的 mean 和 scale 值的文件。
- dataset.txt 为模型量化的校准文件集文件。
- space_shuttle_224x224.jpg 为测试输入图片和教准集中包含的校准图片 。
- input_outputs.txt 包含模型输入输出节点文件。(如果有必要需设置输出节点,避免量化失败)
.
|-- MobileNetV2_Imagenet.h5
|-- channel_mean_value.txt
|-- dataset.txt
|-- inputs_outputs.txt
`-- space_shuttle_224x224.jpg

0 directories, 5 files
导入模型
pegasus_import.sh 模型导入脚本,可以将多种不同的 AI 框架模型进行模型结构和权重解析, 并输出模型解析后的文件:
- 模型架构会保存在 MODEL_DIR.json
- 模型权重会保存在 MODEL_DIR.data
- 自动生成模型输入文件模板 MODEL_DIR_inputmeta.yml
- 自动生成模型后处理文件模板 MODEL_DIR_postprocess_file.yml
# pegasus_import.sh MODEL_DIR
./pegasus_import.sh MobileNetV2_Imagenet/
参数:
- MODEL_DIR 包含源模型文件的文件夹
手动修改模型输入文件
这里需要按照模型输入预处理的 mean, scale 对 MobileNetV2_Imagenet_inputmeta.yml 中的 mean 和 scale 进行手动设置。
这里以 MobileNetV2_ImageNet 为例子,因为 MobileNet 的输出为 (1,224,224,3) RGB 三通道,根据模型预处理公式:
x1 = (x - mean) / std
x1 = (x - mean) * scale
scale = 1 / std
因为训练数据集为 ImageNet, 这里 ImageNet 训练集的归一化 mean 为 [0.485, 0.456, 0.406],std 为 [0.229, 0.224, 0.225], 这里需要进行进行反归一化计算。归一化数据参考 pytorch 文档
# mean
0.485 * 255 = 123.675
0.456 * 255 = 116.28
0.406 * 255 = 103.53
# scale
1 / (0.229 * 255) = 0.01712
1 / (0.224 * 255) = 0.01751
1 / (0.225 * 255) = 0.01743
这里按照计算得出 mean 和 scale 修改 MobileNetV2_Imagenet_inputmeta.yml 中 mean 和 scale 的数值:
mean:
- 123.675
- 116.28
- 103.53
scale:
- 0.01712
- 0.01751
- 0.01743
量化模型
模型在进行转换之前,可以对模型进行不同类型的量化,ACUITY 支持 uint8 / int16 / bf16 / pcq (int8 per-channel quantized)多种量化方式, 如使用 float 表示不进行量化。
使用 pegasus_quantize.sh 脚本可对模型进行指定类型的量化。
如果源模型本身已经是量化模型,这里无需进行量化,否则会报错。
# pegasus_quantize.sh MODEL_DIR QUANTIZED ITERATION
pegasus_quantize.sh MobileNetV2_Imagenet int16 10
量化会生成对应量化方式的量化文件 MODEL_DIR_QUANTIZED.quantize
| QUANTIZED | TYPE | QUANTIZER |
|---|---|---|
| uint8 | uint8 | asymmetric_affine |
| int16 | int16 | dynamic_fixed_point |
| pcq | int8 | perchannel_symmetric_affine |
| bf16 | bf16 | qbfloat16 |
推理量化模型
模型经过量化后,性能会有不同程度的提升,但是精度会稍微降低,经过量化的模型可以通过 pegasus_inference.sh 进行推理,验证量化后模型精度是否满足。
测试推理的输入为 dataset.txt 里的第一张图片。
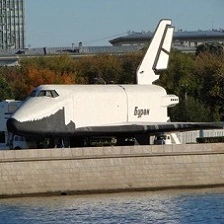
推理 float 类型模型
推理未量化的 float 模型,得到结果作为量化模型结果的参考
# pegasus_inference.sh MODEL_DIR QUANTIZED ITERATION
pegasus_inference.sh MobileNetV2_Imagenet/ float
推理结果输出为
I 07:01:06 Iter(0), top(5), tensor(@attach_Logits/Softmax/out0_0:out0) :
I 07:01:06 812: 0.9990391731262207
I 07:01:06 814: 0.0001562383840791881
I 07:01:06 627: 8.89502334757708e-05
I 07:01:06 864: 6.59249781165272e-05
I 07:01:06 536: 2.808812860166654e-05
这里输出的 top5 置信度最高为 812, 对应 label 为 space shuttle, 这与实际的输入图片类型吻合, 这表明模型输入预处理的 mean 和 scale 设置正确。
推理的 tensor 同时保存在 MODEL_DIR/inf/MODEL_DIR_QUANTIZED 文件夹中
- iter_0_input_1_158_out0_1_224_224_3.qnt.tensor 为原图片的 tensor
- iter_0_input_1_158_out0_1_224_224_3.tensor 为经过预处理后的模型输入 tensor
- iter_0_attach_Logits_Softmax_out0_0_out0_1_1000.tensor 为模型的输出 tensor
.
|-- iter_0_attach_Logits_Softmax_out0_0_out0_1_1000.tensor
|-- iter_0_input_1_158_out0_1_224_224_3.qnt.tensor
`-- iter_0_input_1_158_out0_1_224_224_3.tensor

0 directories, 3 files
推理 uint8 量化模型
# pegasus_inference.sh MODEL_DIR QUANTIZED ITERATION
pegasus_inference.sh MobileNetV2_Imagenet/ uint8
推理结果输出为
I 07:02:20 Iter(0), top(5), tensor(@attach_Logits/Softmax/out0_0:out0) :
I 07:02:20 904: 0.8729746341705322
I 07:02:20 530: 0.012925799004733562
I 07:02:20 905: 0.01022859662771225
I 07:02:20 468: 0.006405209191143513
I 07:02:20 466: 0.005068646278232336
这里输出的 top5 置信度最高为 904, 这里需要注意的是 904 对应 label 是 wig 这与输入的图片结果并不一致,
并且与 float 类型的推理结果不一致,这意味着 uint8 量化后出现精度损失,此时可应用更高精度的量化模型,比如 pcq 或 int16 。 对于提高模型精度的方法请参考 混合量化
推理 pcq 量化模型
# pegasus_inference.sh MODEL_DIR QUANTIZED ITERATION
pegasus_inference.sh MobileNetV2_Imagenet/ pcq
推理结果输出为
I 03:36:41 Iter(0), top(5), tensor(@attach_Logits/Softmax/out0_0:out0) :
I 03:36:41 812: 0.9973124265670776
I 03:36:41 814: 0.00034916045842692256
I 03:36:41 627: 0.00010834729619091377
I 03:36:41 833: 9.26952125155367e-05
I 03:36:41 576: 6.784773722756654e-05
这里输出的 top5 置信度最高为 812, 对应 label 为 space shuttle, 这与实际的输入图片类型吻合,且与 float 类型推理结果一致,这表明在 pcq 量化时精度正确。
推理 int16 量化模型
# pegasus_inference.sh MODEL_DIR QUANTIZED ITERATION
pegasus_inference.sh MobileNetV2_Imagenet/ int16
推理结果输出为
I 06:54:23 Iter(0), top(5), tensor(@attach_Logits/Softmax/out0_0:out0) :
I 06:54:23 812: 0.9989829659461975
I 06:54:23 814: 0.0001675251842243597
I 06:54:23 627: 9.466391202295199e-05
I 06:54:23 864: 6.788487371522933e-05
I 06:54:23 536: 3.0241633794503286e-05
这里输出的 top5 置信度最高为 812, 对应 label 为 space shuttle, 这与实际的输入图片类型吻合,且与 float 类型推理结果一致,这表明在 int16 量化时精度正确。
模型编译并导出
pegasus_export_ovx.sh 可以导出 NPU 推理所需的模型文件和项目代码,
这里以 INT16 量化模型为例子
# pegasus_export_ovx.sh MODEL_DIR QUANTIZED
pegasus_export_ovx.sh MobileNetV2_Imagenet int16
生成 OpenVX 项目和 NBG 项目路径:
- MODEL_DIR/wksp/MODEL_DIR_QUANTIZED : 跨平台的 OpenVX 项目,需要硬件即时编译 (JIT) 进行模型初始化。
- MODEL_DIR/wksp/MODEL_DIR_QUANTIZED_nbg_unify: NBG 格式,预编译机器码格式,低开销,初始化速度快。
(.venv) root@focal-v4l2:~/work/Acuity/acuity_examples/models/MobileNetV2_Imagenet/wksp$ ls
MobileNetV2_Imagenet_int16  MobileNetV2_Imagenet_int16_nbg_unify
在 NBG 项目中可得到 network_binary.nb 模型文件。编译后的模型可复制到板端使用 vpm_run 或者 awnn API 进行板端推理
使用 Vivante IDE 模拟运行推理
使用 Vivante IDE 可以在 X86 PC 上的 ACUITY Docker 中对生成的目标模型和 OpenVX 项目进行验证。
导入 Vivante IDE 所需环境变量
export USE_IDE_LIB=1
export VIVANTE_SDK_DIR=~/Vivante_IDE/VivanteIDE5.11.0/cmdtools/vsimulator
export LD_LIBRARY_PATH=$LD_LIBRARY_PATH:~/Vivante_IDE/VivanteIDE5.11.0/cmdtools/common/lib:~/Vivante_IDE/VivanteIDE5.11.0/cmdtools/vsimulator/lib
unset VSI_USE_IMAGE_PROCESS
模拟运行跨平台 OpenVX 项目
编译可执行文件
cd MobileNetV2_Imagenet/wksp/MobileNetV2_Imagenet_int16
make -f makefile.linux
生成的目标文件为 MODEL_DIR_QUANTIZED 的二进制可执行文件。
运行可执行文件
# Usage: ./mobilenetv2imagenetint16 data_file inputs...
./mobilenetv2imagenetint16 MobileNetV2_Imagenet_int16.export.data ../../space_shuttle_224x224.jpg
运行结果:
Create Neural Network: 11ms or 11426us
Verify...
Verify Graph: 2430ms or 2430049us
Start run graph [1] times...
Run the 1 time: 229309.52ms or 229309520.00us
vxProcessGraph execution time:
Total   229309.53ms or 229309536.00us
Average 229309.53ms or 229309536.00us
 --- Top5 ---
812: 0.999023
814: 0.000146
627: 0.000084
864: 0.000067
  0: 0.000000
模拟运行 NBG 项目
使用 Vivante IDE 运行 NBG 项目耗时会增大
编译可执行文件
cd MobileNetV2_Imagenet/wksp/MobileNetV2_Imagenet_int16_nbg_unify
make -f makefile.linux
生成的目标文件为 MODEL_DIR_QUANTIZED 的二进制可执行文件。
运行可执行文件
# Usage: ./mobilenetv2imagenetint16 data_file inputs...
./mobilenetv2imagenetint16 network_binary.nb ../../space_shuttle_224x224.jpg
运行结果:
Create Neural Network: 4ms or 4368us
Verify...
Verify Graph: 2ms or 2482us
Start run graph [1] times...
Run the 1 time: 229388.50ms or 229388496.00us
vxProcessGraph execution time:
Total   229388.52ms or 229388512.00us
Average 229388.52ms or 229388512.00us
 --- Top5 ---
812: 0.999023
814: 0.000146
627: 0.000084
864: 0.000067
  0: 0.000000
板端 NPU 推理
板端 使用 NPU 推理 NBG 格式模型,可使用 vpm_run 工具进行推理测试,
vpm_run 安装与使用请参考 vpm_run 模型测试工具